Zehn Stunden ohne Wasser, und der Wächter schwieg
Ein Ventil schloss um Mitternacht und ging nicht wieder auf. Die Überwachung dafür schwieg — aus einem Grund, der jeden Alarm im Haus betrifft.
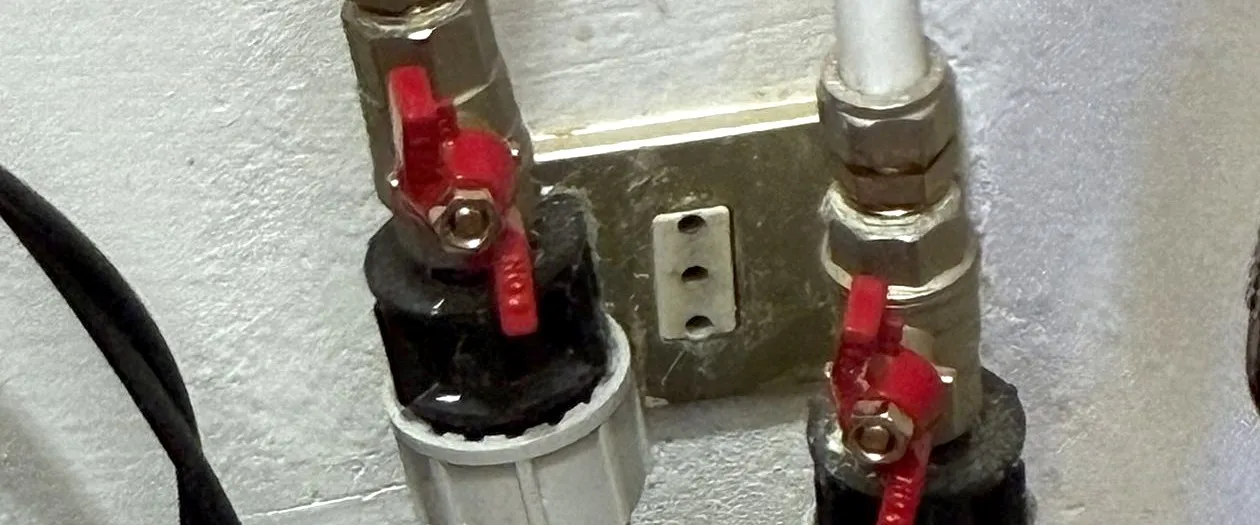
In der Wohnung in Meran sitzen zwei motorische Absperrventile, eines für Kalt-, eines für Warmwasser. Beim Verlassen gehen sie zu, beim Ankommen wieder auf. Dafür gibt es einen Wächter: Wasser zu bei belegter Wohnung soll gemeldet werden.
An einem Dienstag standen beide zehn Stunden lang zu, bei belegter Wohnung. Der Wächter hat nichts gesagt.
Der Grund ist allgemein genug, um jeden Alarm im Haus zu betreffen.
Was passiert ist
00:00:36   Warmwasser zu
00:00:39   Kaltwasser zu
10:27      Nachfrage, warum kein Wasser kommt
Punkt Mitternacht, beide gleichzeitig. Das ist die Uhrzeit der Anti-Rost-Fahrt: Die Ventile öffnen und schließen laut Handbuch jede Nacht einmal, damit sie nicht festsitzen.
Diesmal haben sie geschlossen und nicht wieder geöffnet. Der Zählerstand bestätigt es: seit dem Vorabend kein einziger Liter.
Der Befund: zwei Entitäten, eine Wahrheit
Jedes Ventil erscheint in Home Assistant doppelt — einmal als Ventil, einmal als Schalter. Gleiches Gerät, gleiche Integration, gleicher Datenstrom.
Sie sind nicht gleichwertig:
Schalter     ein  ->  aus             durchgehend abrufbar
Ventil       auf  ->  nicht verfügbar  zehn Stunden lang
Der Schalter hat die Wahrheit die ganze Nacht korrekt gemeldet. Die Ventil-Entität ist verstummt.
Sie kam erst zurück, als ein Befehl an das Gerät ging. Sie lebt offenbar davon, dass das Gerät ihren Datenpunkt von sich aus schickt — und nach einer Fahrt, die das Gerät selbst ausgelöst hat, tut es das nicht.
Ein Neuladen der Integration half nicht: Danach lieferten Temperatur, Zählerstand und alle Schalter wieder Daten, die Ventil-Entitäten blieben stumm.
Warum der Wächter geschwiegen hat
Die Automatisierung sah so aus:
triggers:
  - trigger: state
    entity_id: [valve.kaltwasser, valve.warmwasser]
    to: "closed"
conditions:
  - condition: state
    entity_id: valve.kaltwasser
    state: "closed"
Sie wartete auf closed. Gekommen ist unavailable.
Der Auslöser hat nie gefeuert, und die Bedingung hätte ebenfalls nicht gegriffen. Technisch hat alles funktioniert. Es war nur auf den falschen Zustand gebaut.
Ein Wächter, der auf einen bestimmten Fehlzustand wartet, ist blind für jeden anderen.
Gefragt ist nicht „steht
closedda“, sondern „steht nichtopenda“.unavailableist genauso wenig offen wieclosed— und im Zweifel schlimmer, weil dann niemand weiß, was das Ventil überhaupt tut.
Das ist dieselbe Fehlerklasse wie eine Bedingung, die den Normalfall sauber beschreibt und den Ausnahmefall stillschweigend ausschließt. Sie sieht beim Schreiben vollkommen richtig aus.
Was geändert wurde
Der Wächter fragt jetzt die Schalter, nicht die Ventil-Entitäten, und prüft auf nicht offen statt auf geschlossen:
conditions:
  - condition: template
    value_template: >-
      {{ not is_state('switch.kaltwasser', 'on')
         or not is_state('switch.warmwasser', 'on') }}
Dazu drei Kleinigkeiten, jede mit Grund:
Stufe „Warnung“ statt „Information“. Kein Wasser in einer bewohnten Wohnung ist keine Randnotiz.
Eine Dreistundenprobe als zusätzlicher Auslöser. Ein Zustand, der schon vor einem Neustart bestand, erzeugt danach keinen Zustandswechsel mehr — gefunden werden soll er trotzdem. Das ist der Fall, den reine Ereignisauslöser grundsätzlich verpassen.
Höchstens eine Meldung alle sechs Stunden. Sonst meldet die Dreistundenprobe einen Dauerzustand dreimal am Tag, und nach drei Tagen wischt man sie weg, ohne hinzusehen.
Geöffnet wurde das Wasser über die Schalter — also über die Entitäten, die antworteten. Beide Ventil-Entitäten sprangen im selben Moment zurück.
Und danach wurde nicht nur dieser eine Wächter umgestellt, sondern das ganze Paket. Eine halbe Umstellung hätte bedeutet, dass derselbe Fehler an elf anderen Stellen weiterlebt.
Was ich dir rate
- Frag nach „nicht gut“ statt nach „schlecht“. Jede Prüfung, die einen konkreten Fehlzustand nennt, hat eine Lücke in der Größe aller anderen Zustände.
- Behandle
unavailableals Alarm, nicht als Ausnahme. Ein Sensor, der schweigt, ist kein Sensor, der Entwarnung gibt. - Bau zu jedem Ereignisauslöser eine Zeitprobe dazu. Sonst ist jeder Zustand unsichtbar, der einen Neustart überdauert hat.
- Prüf, welche von zwei Entitäten desselben Geräts belastbar ist. Gleiche Integration heißt nicht gleiche Zuverlässigkeit. Hier war der simplere Datenpunkt der robustere.
- Begrenze die Wiederholung. Eine Meldung, die dreimal täglich dasselbe sagt, wird zu Hintergrundrauschen — und das ist dann genauso still wie keine Meldung.
Und was heißt das?
Der eigentliche Schaden war gering: zehn Stunden kein Wasser, bemerkt durch einen Menschen, der den Hahn aufdrehte.
Der eigentliche Befund ist größer. Ich hatte einen Wächter gebaut, ihn für fertig gehalten und nie den Fall durchgespielt, in dem die überwachte Entität nicht „falsch“ meldet, sondern gar nichts.
Das ist derselbe Mechanismus wie bei der Überwachung, die ihr eigenes Schweigen nicht bemerkt. Und es ist der Grund, warum ich inzwischen bei jedem neuen Alarm zuerst frage, nicht wie er auslöst, sondern wie er aussieht, wenn die Quelle verschwindet.
Ein Alarm, der nur bei einem bestimmten Fehler anschlägt, deckt genau einen Fehler ab. Der nächste sieht immer anders aus.
Wenn du das verfolgen willst: nimm RSS
Kein Newsletter. Du gibst mir keine Adresse, ich führe keine Liste, und niemand muss einer Einwilligung zustimmen, um zu erfahren, dass ein Artikel fertig ist. RSS ist die ältere und für beide Seiten ehrlichere Lösung.
Wie das geht, und warum kein Newsletter
- 1Hol dir einen Feed-Leser. Ohne Konto geht das mit einer App am Telefon oder einer Erweiterung im Browser; wer mag, nimmt einen Dienst mit Konto.
- 2Trag die Adresse von oben dort ein.
- 3Fertig. Neue Artikel erscheinen von selbst in deinem Leser — ungelesen bleibt ungelesen, und nichts landet zwischen Rechnungen und Werbung im Postfach.
Warum das besser ist: Dein Leser holt die Datei ab. Ich bekomme keine Adresse und kann nicht sehen, wer liest oder ob jemand geöffnet hat. Abbestellen heißt, den Eintrag zu löschen — ohne Link, ohne Bestätigungsmail, ohne mich.
Dazu passend
Ein Umlaut hat meine Frostwarnung getötet
Drei Fehler liefen monatelang unbemerkt, einer davon in einer Schutzfunktion. Gefunden wurden sie an einem Abend — und zwei frühere Befunde musste ich zurücknehmen.
Die SD-Karte ist draußen — ein Tag am falschen Ende
Zweimal verlorene Langzeitstatistik, vier korrupte Datenbankdateien. Der Umzug auf eine NVMe kostete einen Tag, zwei fremde Fehler und zwei eigene Irrtümer.
Zwei Wasserventile, und das Absperren macht nicht das Gerät
Warmwasser schließt fast alle Messventile aus. Welches übrig blieb, was dagegen spricht — und warum das Öffnen zwei Bremsen hat und das Schließen keine.